Volver a Proyectos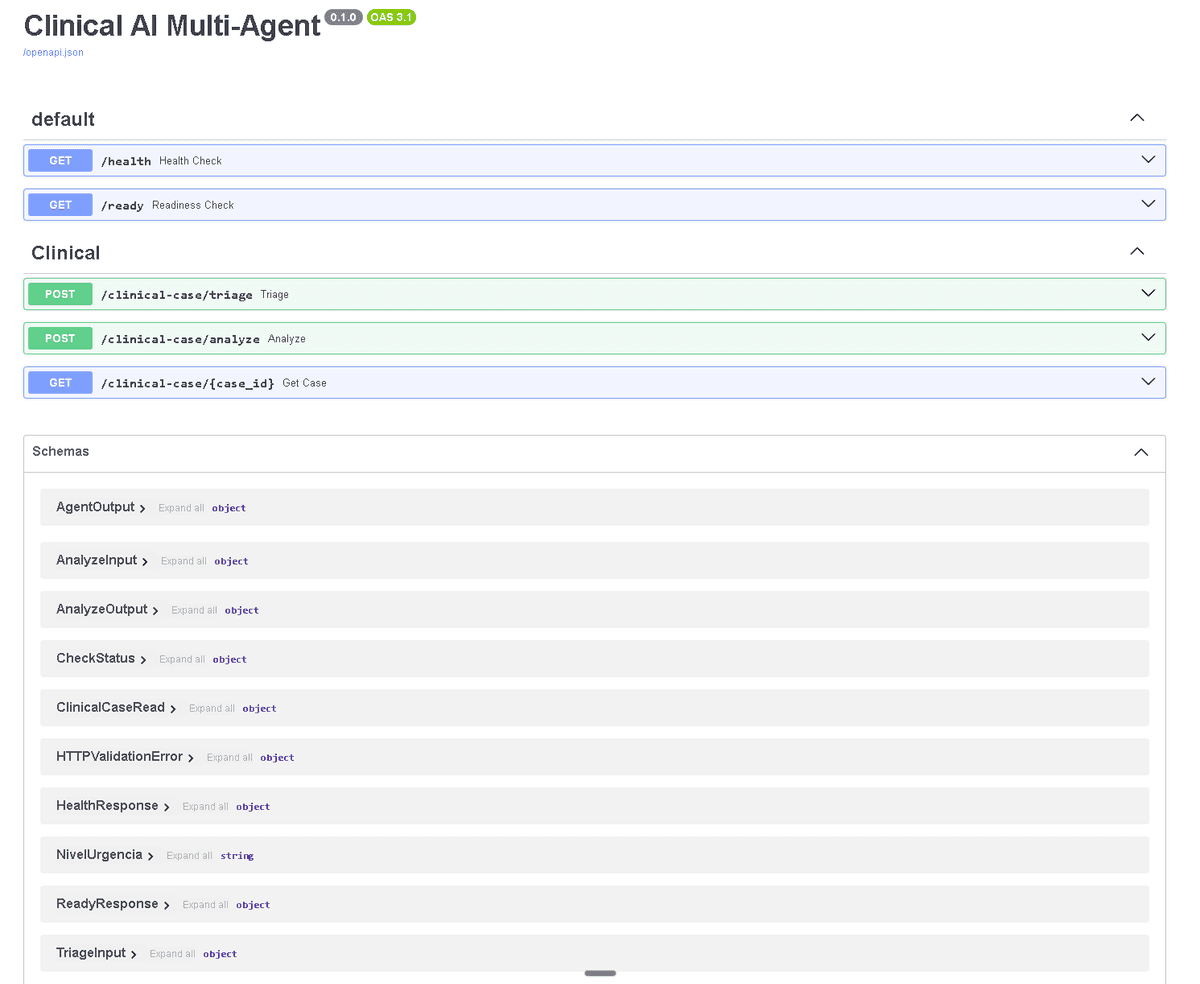
Backend IA · Producción
Clinical AI Multi-Agent
Backend de IA multi-agente de nivel producción para soporte en decisión clínica. Recibe la descripción de un caso, clasifica la urgencia mediante triage con LLM, activa agentes especialistas en paralelo y devuelve una evaluación integrada y tipada, con tolerancia a fallos parciales.
POST /clinical-case/analyze
        │
        ▼
   AgentRouter   ── triage LLM (temp=0.0)
   urgencia + agentes sugeridos
        │
        ▼
   Integrator ── asyncio.gather (paralelo)
   ┌───────────────┬───────────────┐
   ClinicalAgent   EmergencyAgent  CardiologyAgent ...
   │   cada agente: retriever | prompt | llm | parser
   │   (RAG sobre guías clínicas en pgvector)
   └───────────────┴───────────────┘
        │
        ▼
   AnalyzeOutput
   summary · findings · red_flags ·
   recommendations · confidence ·
   failed_agents · warnings
De un vistazo
- Tipo de proyecto
- Proyecto personal
- Rol
- Proyecto personal de backend con IA aplicada, diseñado y construido de extremo a extremo.
- Stack
- Python
- FastAPI (async)
- LangChain LCEL
- pgvector
- PostgreSQL
- SQLAlchemy 2.0
- Pydantic v2
- Docker
- Enlaces
Qué demuestra
- Orquestación asíncrona: agentes especialistas en paralelo con asyncio.gather y tolerancia a fallos parciales.
- RAG por agente sobre pgvector y respuestas tipadas con Pydantic.
- Servicio pensado para producción: Docker multi-stage, integración continua hacia GHCR y despliegue con Traefik.
La API · OpenAPI
Superficie REST documentada con esquemas tipados: triage, análisis multi-agente y consulta de casos.
Arquitectura
Recorrido de una petición: del endpoint al resultado tipado.
- API · FastAPI, Caso clínico. POST /clinical-case/analyze recibe la descripción del caso en lenguaje natural. Siguiente: AgentRouter.
- AgentRouter, Triage con LLM. Un LLM con temperature=0.0 clasifica la urgencia y sugiere los agentes especialistas según el contenido del caso. Siguiente: Integrator.
- Integrator, asyncio.gather. Ejecuta en paralelo los agentes seleccionados; si uno falla, el resto devuelve igual su resultado. Siguiente: Agentes.
- Agentes, RAG · pgvector. Clinical, Emergency, Cardiology y otros: cada uno encadena retriever, prompt, LLM y parser sobre guías clínicas en pgvector. Siguiente: AnalyzeOutput.
- AnalyzeOutput, Salida tipada. Evaluación integrada con summary, findings, red_flags, recommendations, confidence, failed_agents y warnings. Fin del flujo.
El Concepto
Un único endpoint recibe un caso clínico en lenguaje natural.
- Router Un router basado en LLM clasifica la urgencia y decide qué agentes especialistas (emergencias, cardiología, farmacología, radiología…) necesita el caso según su contenido semántico, no solo según el nivel de urgencia.
- Agentes Cada agente ejecuta su propia cadena RAG independiente.
- Integrator Combina los resultados en una única evaluación tipada.
Decisiones Técnicas
- Triage determinista: el router corre a
temperature=0.0para que la clasificación de urgencia y la selección de agentes sean reproducibles, no aleatorias. - Activación por contenido: los agentes especialistas se activan por el contenido del caso (una lectura de ECG activa cardiología) y no por el nivel de urgencia.
- Ejecución paralela: todos los agentes seleccionados corren concurrentemente con
asyncio.gather; tres agentes de ~2 s tardan ~2 s en total, no 6 s. - RAG por agente: cada agente recupera guías clínicas relevantes desde pgvector vía LangChain (
retriever | prompt | llm | parser) y parsea una respuesta tipada con Pydantic. - Resiliencia: con
return_exceptions=True, si un agente falla o expira, el resto devuelve igual su resultado; los camposfailed_agentsywarningshacen explícita la degradación parcial. - Proveedores intercambiables: LLM y embeddings son agnósticos del proveedor (Nvidia NIM, Groq, OpenAI, LM Studio) mediante una capa compatible con OpenAI.
Lo que Demuestra
Es la pieza donde la arquitectura backend y la IA aplicada se encuentran. No es una demo de LLM, es un servicio diseñado para producción.
- Backend Orquestación asíncrona, recuperación semántica, contratos de datos tipados y resiliencia ante fallos parciales.
- Empaquetado Docker multi-stage, integración continua hacia GHCR y despliegue en VPS con Traefik y TLS automático.